Sistemas de IA Multi-Agente en Investigación Clínica: Más allá del paradigma de modelo único
Respuesta corta
Un solo LLM no puede gestionar de forma fiable un ensayo clínico, pero un sistema de agentes especializados con roles definidos, puertas de validación y protocolos de fallo sí puede manejar documentos regulatorios, datos de pacientes y coordinación de investigación. La validación con humano en el bucle es innegociable, y el enfoque multi-agente no sirve para todos los problemas.
Diego Muñoz Casinos
Healthcare AI Engineer
El problema del modelo único
Cuando las organizaciones adoptan por primera vez IA en investigación clínica, el instinto es lanzar un solo modelo de lenguaje al problema: "Usemos GPT/Claude para revisar nuestros documentos regulatorios." El resultado suele ser impresionante en una demo y poco fiable en producción.
¿Por qué? Porque las tareas de investigación clínica requieren diferentes modos cognitivos. Extraer eventos adversos de narrativas es una tarea diferente a comprobar cumplimiento del protocolo, que es diferente a generar planes de análisis estadístico. Un solo modelo, con un prompt genérico, carece de la especialización y las barreras de seguridad para manejar estas tareas diversas de forma fiable.
Qué significa Multi-Agente (y qué no)
Un sistema de IA multi-agente no es simplemente "múltiples llamadas a API." Es una arquitectura donde:
- •Cada agente tiene un rol definido — p.ej., un agente de Cumplimiento de Protocolo, un agente de Extracción de Datos, un agente de Revisión Estadística
- •Los agentes se comunican a través de interfaces estructuradas — no cadena de pensamiento en texto libre, sino inputs y outputs tipados con esquemas
- •Puertas de validación se sitúan entre agentes — el output del Agente A se verifica antes de que el Agente B lo procese
- •Cada agente tiene su propio protocolo de fallo — qué pasa cuando la confianza es baja o el input está malformado
La diferencia clave respecto a un enfoque monolítico es la separación de responsabilidades. Cada agente puede ser testeado, validado y mejorado independientemente sin afectar al resto del sistema.
Arquitectura para Investigación Clínica
Aquí hay una arquitectura práctica que nuestro equipo ha diseñado para procesamiento de documentos de investigación clínica:
Capa 1: Agentes de Ingesta
- •Parser de Documentos: Extrae contenido estructurado de PDFs, DOCX y documentos escaneados (OCR + análisis de layout)
- •Agente de Clasificación: Enruta el documento al pipeline de procesamiento correcto (¿enmienda de protocolo? ¿informe SAE? ¿formulario de consentimiento?)
Capa 2: Agentes de Procesamiento
- •Agente de Cumplimiento de Protocolo: Verifica documentos contra el protocolo del estudio y requisitos ICH-GCP2. Tiene un checklist estructurado, no análisis de forma libre.
- •Agente de Extracción de Datos: Extrae campos específicos (fechas, dosis, eventos adversos, valores de laboratorio) a formatos estructurados. Produce JSON tipado, no prosa.
- •Agente de Codificación Médica: Mapea términos de texto libre a codificación MedDRA1/WHO-Drug3 con scores de confianza.
Capa 3: Agentes de Validación
- •Agente de Referencias Cruzadas: Compara datos extraídos contra entradas existentes en base de datos para consistencia
- •Agente de Puerta de Calidad: Aplica reglas de negocio y marca discrepancias para revisión humana
- •Agente de Audit Trail: Registra cada decisión, score de confianza y transformación de datos para trazabilidad regulatoria
Capa 4: Interfaz Humana
- •Dashboard de Revisión: Presenta ítems marcados a asociados de investigación clínica con contexto completo
- •Protocolo de Escalación: Enruta automáticamente discrepancias de alto riesgo a monitores médicos senior
Por qué las puertas de validación importan — HITL es innegociable
En investigación clínica, un error no es solo un bug — es una potencial violación regulatoria con multas millonarias y, lo más importante, vidas de pacientes en juego. Ningún output de IA en pharma o salud debería alcanzar una decisión final sin revisión humana-in-the-loop (HITL) y firma. Los sistemas multi-agente manejan esto a través de puertas de validación:
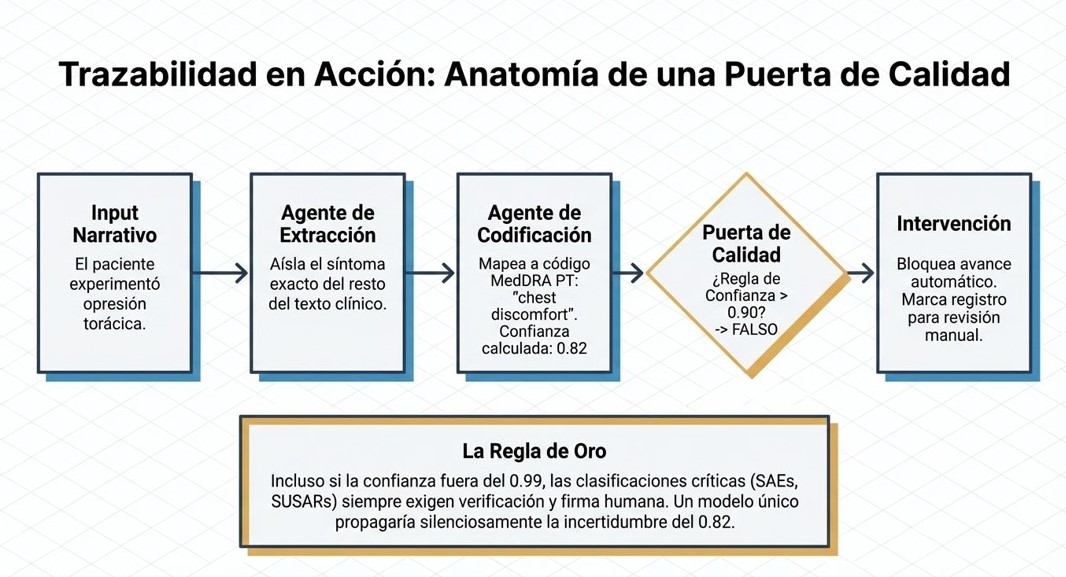
Entre extracción y codificación:
El Agente de Extracción produce un término de evento adverso: "el paciente experimentó opresión torácica." El Agente de Codificación Médica lo mapea a MedDRA PT "chest discomfort" con confianza 0.82. La Puerta de Calidad verifica: ¿confianza > 0.90? No → marca para revisión humana. Incluso por encima de 0.90, las clasificaciones críticas (SAEs, SUSARs) siempre requieren verificación humana y firma digital antes de proceder. Un modelo único propagaría silenciosamente la incertidumbre.
Entre procesamiento y almacenamiento:
Cada transformación de datos se registra con: input, output, ID de agente, versión del modelo, score de confianza y timestamp. Antes de que cualquier dato validado entre en el pipeline de submisión regulatoria, un revisor cualificado debe aprobar y firmar el registro. Esto crea el audit trail que los auditores e inspectores GCP esperan2 — no solo trazabilidad, sino responsabilidad humana documentada en cada nodo crítico. No puedes retrofit esto en un sistema monolítico.
Beneficios prácticos que hemos observado
1. Testeabilidad
Cada agente tiene un contrato definido de input/output. Puedes escribir tests unitarios: "Dada esta narrativa de evento adverso, el agente de extracción debe devolver estos campos estructurados." Intenta escribir un test unitario significativo para un prompt monolítico.
2. Mejora incremental
Cuando el Agente de Codificación Médica rinde por debajo de lo esperado en un dominio específico (p.ej., terminología cardíaca), actualizas el system prompt de ese agente, sus diccionarios de referencia o ejemplos few-shot — sin tocar ningún otro agente. El resto del sistema sigue operando. En un sistema monolítico, modificar el prompt para una tarea arriesga degradar el rendimiento en todas las demás.
3. Transparencia regulatoria
Cuando un regulador pregunta "¿cómo clasificó su sistema este evento adverso?", puedes trazar el camino exacto: Parser de Documentos → Agente de Clasificación → Agente de Extracción → Agente de Codificación Médica → Puerta de Calidad → Revisión Humana. Cada paso está registrado. Este nivel de explicabilidad es casi imposible con un enfoque de modelo único.
4. Degradación elegante
Si la API del Agente de Codificación Médica está caída, el sistema no se detiene. Los documentos continúan a través de extracción y se encolan para codificación. En un sistema monolítico, cualquier fallo es un fallo total.
Consideraciones de implementación
Gestión de costes
Los sistemas multi-agente hacen más llamadas a API. Optimiza usando modelos más pequeños y rápidos para tareas simples de routing y reservando modelos grandes para razonamiento complejo. Un agente de clasificación no necesita un modelo frontier — un modelo más pequeño y rápido es suficiente y puede ser órdenes de magnitud más barato.
Latencia
Las cadenas secuenciales de agentes añaden latencia. Diseña para paralelismo donde sea posible: el Agente de Cumplimiento de Protocolo y el Agente de Extracción de Datos pueden procesar el mismo documento simultáneamente.
Prompt engineering por agente
Cada agente necesita un system prompt enfocado con ejemplos específicos del dominio, esquemas de output e instrucciones explícitas de fallo. Prompts genéricos producen resultados genéricos.
Infraestructura de testing
Construye tests de integración que ejecuten pipelines completos de documentos end-to-end. Mide no solo la accuracy individual de cada agente sino los resultados a nivel de sistema: "Para 100 informes SAE, ¿qué porcentaje se procesó correctamente sin intervención humana?"
Cuándo NO usar Multi-Agente
No toda tarea de investigación clínica necesita esta arquitectura:
- •Q&A simple sobre documentos de protocolo → un modelo único con RAG es suficiente
- •Formateo puntual de datos → un script es mejor que IA
- •Tareas sin requisitos de validación → el overhead de agentes no se justifica
Usa multi-agente cuando necesites fiabilidad, trazabilidad y validación independiente — que es la mayoría de tareas de investigación clínica en producción.
Cómo empezar
- 1.Mapea tu workflow: Identifica las tareas cognitivas distintas en tu proceso. Cada tarea distinta es un agente potencial.
- 2.Define interfaces: ¿Qué recibe y produce cada agente? Usa esquemas tipados, no texto libre.
- 3.Construye las puertas de validación primero: Las puertas son más importantes que los agentes. Son lo que hace el sistema confiable.
- 4.Empieza con dos agentes: No construyas la arquitectura completa de una vez. Empieza con extracción + validación, demuestra el valor, luego expande.
Referencias
- 1.MedDRA — Medical Dictionary for Regulatory Activities. Mantenido por ICH. Disponible en: meddra.org
- 2.ICH E6(R3) — Guía de Buenas Prácticas Clínicas. International Council for Harmonisation. Disponible en: ich.org/page/efficacy-guidelines
- 3.WHO Drug Dictionary. Uppsala Monitoring Centre. Disponible en: who-umc.org
¿Diseñando un sistema de IA multi-agente para tu workflow de investigación clínica? Nuestro equipo arquitecta estos sistemas con metodología spec-driven — especificaciones formales, protocolos de validación y KPIs medibles antes de escribir ningún código. Hablemos de tu arquitectura.
¿Estás diseñando un workflow multi-agente para investigación clínica?
Ayudamos a arquitecturar, validar y desplegar sistemas de IA multi-agente con los estándares requeridos en entornos regulados.
Contactar