El filtro invisible que decide si una IA en salud funciona de verdad
Respuesta corta
Ejecutar miles de pruebas estadísticas genera falsos positivos solo por azar: 10.000 comparaciones con p < 0,05 producen unos 500 hallazgos falsos. Controlar la tasa de falsos descubrimientos, como hace el procedimiento de Benjamini-Hochberg, es la respuesta estándar en ómica y ensayos clínicos, y podría servir también como criterio de validación en workflows de IA multi-agente.
Diego Muñoz Casinos
Healthcare AI Engineer
En análisis proteómicos y de enriquecimiento funcional, se comparan miles de hipótesis simultáneamente sobre los mismos datos. Sin corrección por múltiples comparaciones (Benjamini–Hochberg, Bonferroni, Holm), una parte no trivial de los hallazgos son ruido estadístico indistinguible de la señal real. El mismo principio es pieza estándar de los Statistical Analysis Plans en ensayos clínicos confirmatorios bajo ICH E9. Reflexión personal del autor: podría extenderse al diseño de workflows de IA multi-agente — conjetura abierta, no tesis.
Un escenario habitual en proteómica clínica
Imaginemos un equipo de investigación que analiza muestras de pacientes con una enfermedad y quiere identificar qué procesos biológicos están alterados. Utiliza espectrometría de masas para medir miles de proteínas, compara niveles entre pacientes y controles, y obtiene una lista de —digamos— 300 proteínas que superan el umbral nominal de significación.
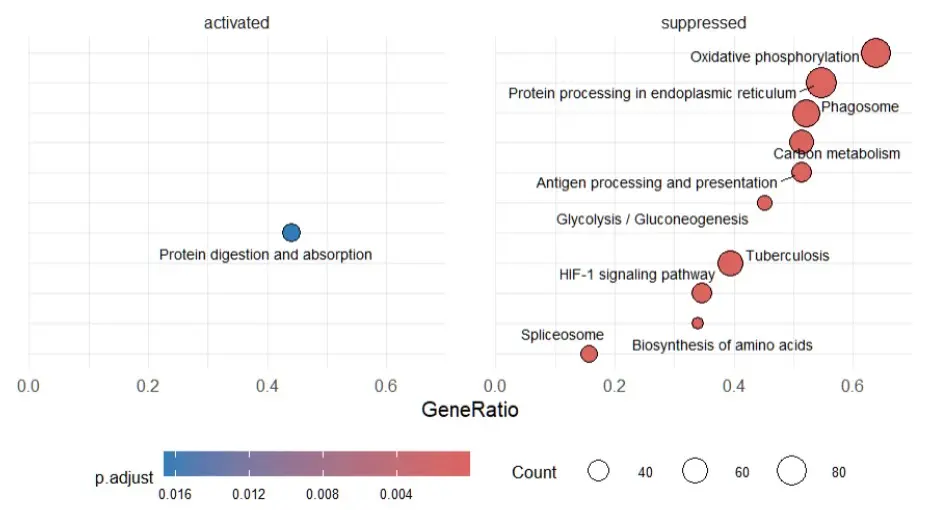
El siguiente paso es el análisis de enriquecimiento funcional: preguntar a una base de datos de rutas biológicas (Gene Ontology, KEGG, Reactome) qué funciones están sobre-representadas en esa lista. El output típico es otra lista: «30 rutas significativas», con su valor-p asociado. ¿Cuántas de esas 30 son hallazgos reales? El principio que responde a esa pregunta es transversal: aparece cada vez que se evalúan muchas hipótesis a la vez sobre los mismos datos —paneles de biomarcadores, endpoints secundarios de ensayos, selección de features en machine learning.
Por qué 10.000 comparaciones generan 500 hallazgos falsos por azar puro
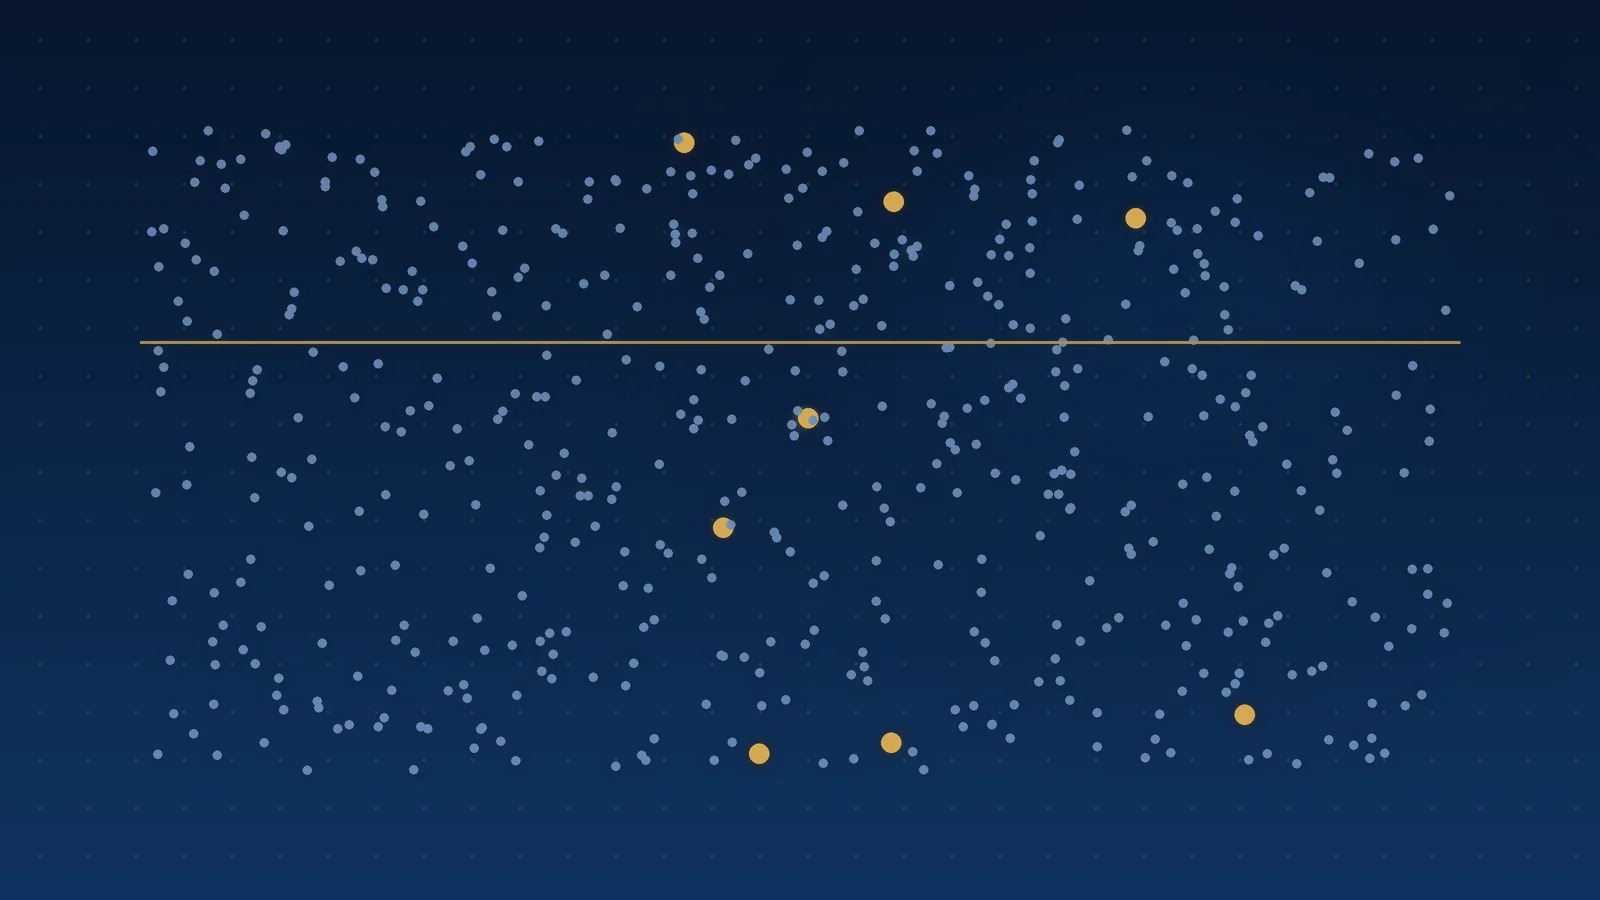
Cada comparación con una ruta biológica es un test estadístico independiente en su planteamiento formal, aunque en la práctica los tests sobre rutas GO, KEGG o Reactome están correlacionados por el solapamiento de genes entre rutas. Esa correlación no elimina el problema de fondo: cuantas más comparaciones haces, más probable es encontrar algo «significativo» por puro azar, y el fenómeno es conocido en bioestadística desde hace décadas.
El cálculo es simple. Si aceptamos un umbral clásico de α = 0,05 como tasa nominal de falso positivo condicionada a la hipótesis nula verdadera, la probabilidad de que al menos uno de varios tests caiga en la región de rechazo por puro azar crece con el número de tests:
- •Con 1 test: 5 %
- •Con 20 tests: aproximadamente 64 %
- •Con 100 tests: más del 99 %
- •Con 10.000 tests: prácticamente 100 %, con un número esperado de 500 falsos positivos si todas las hipótesis nulas fueran verdaderas
Aquí conviene distinguir dos métricas distintas: la probabilidad de cometer al menos un falso positivo (el family-wise error rate o FWER) y la proporción esperada de falsos positivos entre los hallazgos declarados significativos (el false discovery rate o FDR). Son preguntas diferentes con respuestas diferentes, y en ómicas casi siempre interesa la segunda. La consecuencia es seria: si uno se queda con los valores-p crudos sin ningún ajuste, una parte de lo que declara como hallazgo no lo es.
El problema de multiplicidad está bien documentado en la literatura estadística desde hace más de medio siglo —Tukey 1953, Dunn 1961, Miller 1966 entre otros—. El control del FDR específicamente llegó con Benjamini–Hochberg en 19952. No es una crítica a ninguna línea concreta de investigación, sino una observación sobre un fenómeno matemático.
Del FWER al FDR: cómo la bioestadística contuvo el problema
En 1995, Yoav Benjamini y Yosef Hochberg publicaron un artículo que cambió la manera de tratar este problema en ómicas2. En lugar de intentar evitar cualquier falso positivo (el enfoque clásico, llamado control del family-wise error rate), propusieron controlar la proporción esperada de falsos descubrimientos entre los resultados declarados significativos. Esa métrica se llama False Discovery Rate o FDR.
La idea es sutil pero potente: si el equipo fija un umbral aceptable de falsos descubrimientos —típicamente 5 % o 10 %, según el contexto— puede permitirse ser menos estricto en cada test individual sin perder control global sobre el error. El resultado es un mayor número de rechazos al coste de una tasa controlada de falsos descubrimientos, sin que eso implique que cada rechazo individual sea un hallazgo verdadero en sentido material. El procedimiento BH controla el FDR bajo independencia de los tests o bajo una forma de dependencia positiva conocida como PRDS (positive regression dependency on subsets); cuando la estructura de dependencia es arbitraria, la variante Benjamini–Yekutieli (2001) proporciona el control a costa de ser más conservadora.
Unos años después, John Storey y Robert Tibshirani extendieron esa idea con una herramienta práctica: el q-valor, definido como el mínimo FDR al que un test concreto sería declarado significativo, estimando además la proporción de hipótesis nulas verdaderas (π₀) a partir de los propios datos3. En la práctica, las herramientas modernas de análisis de enriquecimiento (GSEA, g:Profiler, DAVID) reportan valores ajustados por FDR junto al valor-p crudo^1,5^.
Bonferroni sigue existiendo y tiene su lugar: es matemáticamente más estricta y resulta útil en análisis confirmatorios con pocas hipótesis preespecificadas —por ejemplo, un ensayo clínico con cinco endpoints primarios fijados antes de mirar los datos—. Una variante secuencial, Holm-Bonferroni, ofrece el mismo control del FWER bajo cualquier estructura de dependencia, sin asunciones adicionales, y con algo menos de pérdida de potencia que Bonferroni clásico7. En contextos de descubrimiento con miles de tests, el FDR se ha convertido en el estándar por buenas razones4.
La elección entre un framework u otro depende del contexto: exploratorio vs. confirmatorio, hipótesis preespecificadas vs. generadas a partir de los datos, consecuencias de un falso positivo vs. consecuencias de un falso negativo. No hay una respuesta universal. Sí hay un gradiente claro: cuanto más cerca está el análisis de una decisión regulatoria o clínica, más justificable es inclinarse hacia el lado estricto del espectro.
El mismo problema en ensayos clínicos
Hasta aquí el ejemplo ha sido proteómico, pero el principio es el mismo en cualquier dominio donde el volumen de hipótesis simultáneas condiciona la interpretación de los resultados. Donde más me llama la atención es en ensayos clínicos, porque ahí la corrección deja de ser un asunto metodológico y se convierte en parte de lo que realmente se está validando ante un regulador.
Un protocolo típico define un endpoint primario y varios endpoints secundarios. Cada endpoint adicional evaluado sobre los mismos pacientes es otro test. Si uno de los secundarios resulta «significativo» sin haber sido preespecificado jerárquicamente con una corrección explícita, el resultado no puede interpretarse como si hubiera sido un endpoint único: la probabilidad acumulada de un falso positivo ya incluye la búsqueda. Los análisis confirmatorios con endpoints múltiples combinan procedimientos jerárquicos de testing (fixed-sequence, gatekeeping) con controles clásicos del family-wise error rate como Bonferroni o Holm-Bonferroni7. En interim analyses de diseños group sequential, los métodos alpha-spending pagan explícitamente el coste estadístico de mirar anticipadamente a los datos. Los análisis de subgrupos son distintos: salvo cuando están preespecificados jerárquicamente en el plan de análisis, permanecen como hallazgos exploratorios aunque se ajusten por multiplicidad, y deben reportarse como tales.
Tres preguntas útiles para quien evalúa un análisis con múltiples hipótesis
Para quien evalúa la validez de un análisis que compara muchas hipótesis simultáneamente —un análisis ómico, un ensayo clínico con varios endpoints, un pipeline ML con selección de features— hay tres preguntas que merecen estar sobre la mesa, y ninguna de ellas requiere formación estadística avanzada.
- 1.¿Cuántas hipótesis se están evaluando realmente, incluyendo las secundarias, exploratorias y derivadas del análisis de subgrupos?
- 2.¿El reporte muestra valor-p ajustado (FDR, q-valor, Bonferroni, Holm) o solo el valor-p crudo?
- 3.¿El criterio de corrección estaba fijado antes de mirar los datos, o se eligió después de ver los resultados?
Las respuestas están casi siempre en la sección de métodos del paper asociado y en el plan de análisis estadístico del protocolo.
Los criterios que aplico en los pipelines ómicos con los que trabajo
En los pipelines de análisis multiómico en los que he trabajado —tanto durante el máster en bioinformática como en los proyectos de investigación— mantengo estos criterios como hábitos operacionales antes de dar por buena cualquier salida de enriquecimiento funcional:
- •Reportar siempre el q-valor o el valor-p ajustado por FDR junto al valor-p crudo en cualquier salida de enriquecimiento.
- •Fijar el umbral de corrección antes de mirar los resultados, no después.
- •Separar explícitamente el análisis exploratorio (donde el FDR es apropiado) del análisis confirmatorio con hipótesis preespecificadas (donde el control del family-wise error rate es el estándar regulatorio bajo ICH E9).
- •Documentar el método de corrección y las justificaciones de elección en el propio entregable, para que sea trazable por cualquier revisor externo.
- •Diferenciar el conjunto de tests realmente ejecutados del conjunto reportado: un análisis con «sólo diez rutas significativas al final» puede esconder miles de comparaciones en el background.
Ninguna de estas prácticas es novedosa. El FDR en selección de genes diferencialmente expresados está documentado desde los primeros años de la expresión génica a gran escala5 y la literatura metodológica reciente los trata como mínimos4. Lo que me parece interesante como ingeniero de sistemas es que, en un pipeline automatizado, estas decisiones dejan de ser responsabilidad del analista individual y se convierten en controles procedimentales aplicados de forma reproducible. La validez inferencial sigue dependiendo del modelo, de los supuestos y del poder real del análisis, pero al menos el proceso queda auditable.
Reflexión: del p-valor ajustado a los workflows multi-agente
Lo que me interesa últimamente, más como ingeniero de sistemas que como estadístico, es la aplicación del mismo principio en el diseño de workflows de IA multi-agente. Un workflow con N agentes evaluando hipótesis en cadena o en paralelo genera múltiples decisiones con incertidumbre, y la de cada agente individual y la del workflow agregado son magnitudes distintas. Sin un mecanismo de control equivalente a FWER o FDR para la cadena completa, el sistema puede acumular error sin que nadie lo note —igual que un análisis ómico sin corrección. Existe literatura contemporánea que aborda piezas del problema desde ángulos distintos (conformal prediction, modelado jerárquico bayesiano), pero no la he visto articulada como disciplina de diseño para pipelines multi-agente. Esta es una conjetura abierta, no una tesis: la planteo como reflexión personal y con la esperanza de que sirva para abrir conversación más que para cerrarla. Si alguien está trabajando este tipo de métricas sobre un workflow real, me interesaría ver los números.
Cierre
«En salud, el rigor estadístico upstream no es un lujo. Es el filtro entre un sistema con señal y un sistema con ruido elegantemente reempaquetado.»
El problema formal de la multiplicidad tiene solución estadística desde hace más de tres décadas, implementada por defecto en casi todas las herramientas contemporáneas. Lo que nunca es automático es la disciplina de aplicarla consistentemente a lo largo de un pipeline completo: desde el test individual hasta el informe que un comité revisa, pasando por el modelo que consume los features seleccionados. Un pipeline que respeta esa cadena no es más complejo. Es simplemente más honesto con los datos que consume y con las decisiones que alimenta downstream.
Referencias peer-reviewed
- 1.Subramanian A, Tamayo P, Mootha VK, et al. Gene set enrichment analysis: a knowledge-based approach for interpreting genome-wide expression profiles. Proc Natl Acad Sci U S A. 2005;102(43):15545–15550. doi:10.1073/pnas.0506580102. PMID: 16199517.
- 2.Benjamini Y, Hochberg Y. Controlling the false discovery rate: a practical and powerful approach to multiple testing. J R Stat Soc Ser B. 1995;57(1):289–300.
- 3.Storey JD, Tibshirani R. Statistical significance for genomewide studies. Proc Natl Acad Sci U S A. 2003;100(16):9440–9445. doi:10.1073/pnas.1530509100. PMID: 12883005.
- 4.Goeman JJ, Solari A. Multiple hypothesis testing in genomics. Stat Med. 2014;33(11):1946–1978. doi:10.1002/sim.6082. PMID: 24399688.
- 5.Reimand J, Isserlin R, Voisin V, et al. Pathway enrichment analysis and visualization of omics data using g:Profiler, GSEA, Cytoscape and EnrichmentMap. Nat Protoc. 2019;14(2):482–517. doi:10.1038/s41596-018-0103-9. PMID: 30664679.
- 6.Varoquaux G, Cheplygina V. Machine learning for medical imaging: methodological failures and recommendations for the future. NPJ Digit Med. 2022;5(1):48. doi:10.1038/s41746-022-00592-y. PMID: 35413988.
- 7.Holm S. A simple sequentially rejective multiple test procedure. Scand J Stat. 1979;6(2):65–70.
- 8.Ioannidis JPA. Why most published research findings are false. PLoS Med. 2005;2(8):e124. doi:10.1371/journal.pmed.0020124. PMID: 16060722.
- 9.Button KS, Ioannidis JPA, Mokrysz C, Nosek BA, Flint J, Robinson ESJ, Munafò MR. Power failure: why small sample size undermines the reliability of neuroscience. Nat Rev Neurosci. 2013;14(5):365–376. doi:10.1038/nrn3475. PMID: 23571845.
- 10.Wacholder S, Chanock S, Garcia-Closas M, El Ghormli L, Rothman N. Assessing the probability that a positive report is false: an approach for molecular epidemiology studies. J Natl Cancer Inst. 2004;96(6):434–442. doi:10.1093/jnci/djh075. PMID: 15026468.
Este artículo es divulgativo. No sustituye a la consulta con un bioestadístico o especialista clínico para aplicaciones específicas. Todos los claims están respaldados por literatura peer-reviewed; las referencias enumeradas son el respaldo primario.
¿Tu algoritmo de IA sanitaria tiene un plan de análisis estadístico?
Ayudamos a definir criterios de validación rigurosos para sistemas de IA en investigación clínica y proteómica.
Contactar